

BI sistemi: zašto SUCCESS ne znači da su podaci ispravni
Većina firmi očekuje da je obrada uspešna ako data pipeline završi bez greške.
Ali tehnički završen proces ne znači da su svi podaci ispravno obrađeni.
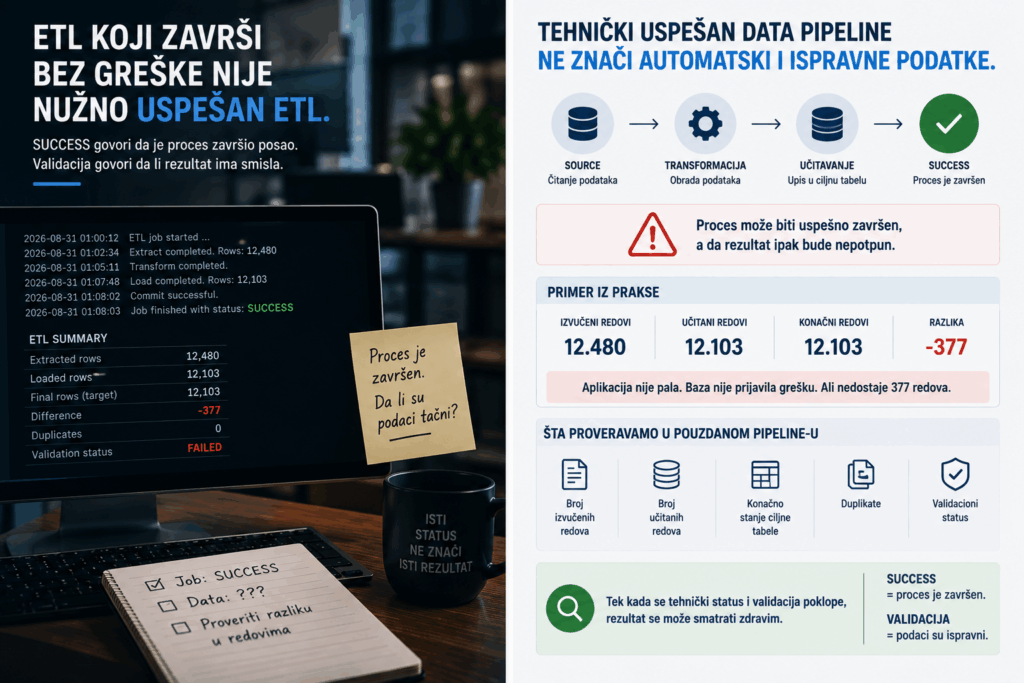
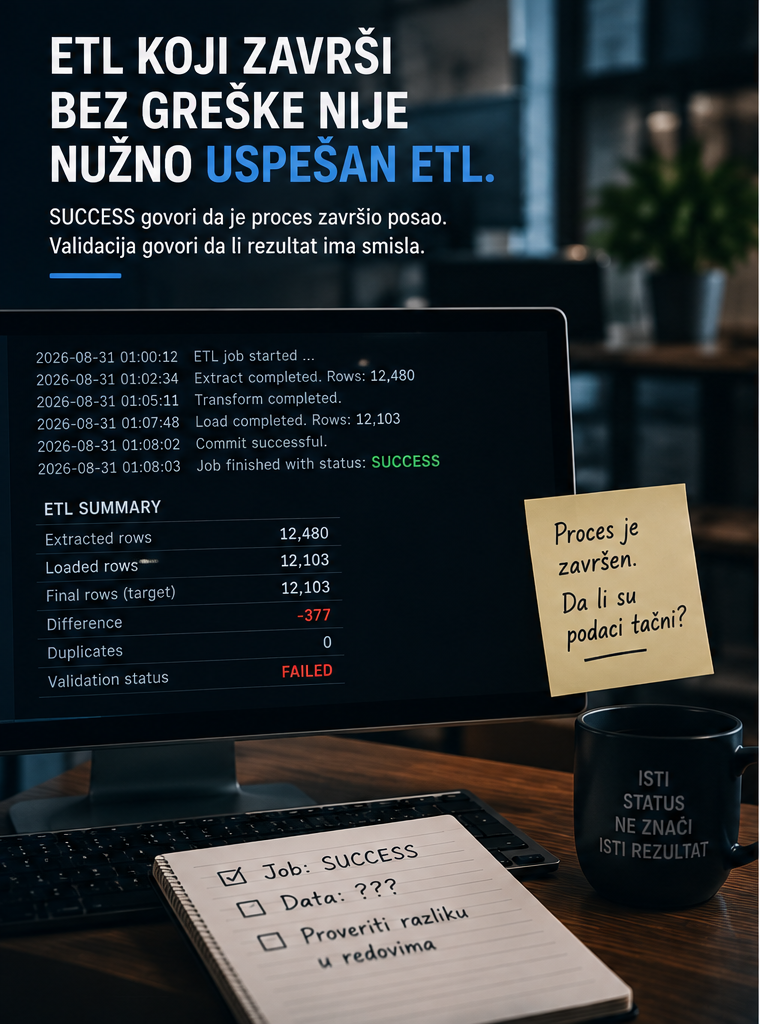
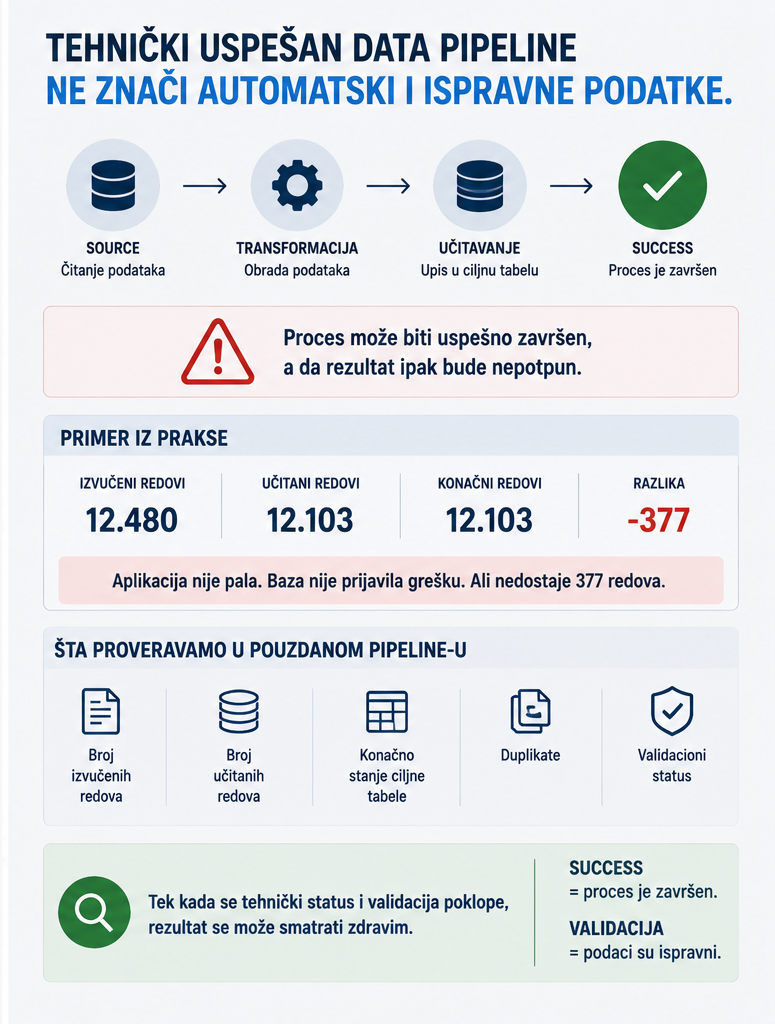
U praksi, ETL može da pročita 12.480 redova, upiše samo 12.103 i ipak završi sa statusom SUCCESS. Dashboard će se otvoriti normalno, ali će u analitičkom sloju nedostajati 377 zapisa.
U ovom tekstu objašnjavamo kako pouzdani BI sistemi odvajaju tehnički status izvršavanja od validacije podataka i kako proveriti rezultat pre nego što stigne do korisnika.
Šta su BI sistemi
BI sistemi povezuju podatke iz ERP-a i drugih izvora, obrađuju ih i pripremaju za izveštavanje i analitiku.
Dashboard je samo poslednji deo tog procesa.
Pre njega podaci prolaze kroz nekoliko koraka:
Izvorni sistem → ekstrakcija → transformacija → učitavanje → validacija → BI model → dashboard
Svaki korak može tehnički da se završi, a da krajnji rezultat ipak nije prihvatljiv.
Zato pouzdan BI sistem mora da prati najmanje dve odvojene stvari:
– execution status — da li je kod završio izvršavanje
– validation status — da li rezultat zadovoljava očekivana pravila
Drugim rečima: SUCCESS govori da je proces završen. Validacija govori da li rezultatu možemo da verujemo.
Problem koji rešavaju BI sistemi
Uzmimo konkretan dnevni pipeline.
Iz izvornog sistema pročitano je:
12.480 redova
Transformacije su završene.
Baza nije prijavila grešku.
ETL proces vraća:
Status: SUCCESS ✅
Na prvi pogled sve izgleda ispravno.
Ali u ciljnu tabelu je stiglo:
12.103 redova
Nedostaje:
377 redova ⚠️
Mogući uzroci su različiti:
– određeni redovi nisu prošli transformaciju
– deo podataka je odbačen zbog nevalidne vrednosti
– INSERT nije obuhvatio ceo skup
– duplikati su nepravilno uklonjeni
– filter je isključio podatke koji nisu smeli biti isključeni
Aplikacija nije pala.
Baza radi.
Dashboard može normalno da se osveži.
Ali poslovni rezultat više nije kompletan.
Glavni problem zato nije u tome da li je ETL završio.
Problem je što tehnički status nije dovoljan dokaz kvaliteta podatka.
Proces može biti uspešan, a rezultat pogrešan.
Zašto dolazi do ovog problema
Najčešći uzrok je što se monitoring zaustavlja na pitanju: „Da li je job završio?“
To je važno, ali nije dovoljno.
Pouzdan data pipeline mora da odgovori i na: „Šta je job proizveo?“
Razlog je kombinacija više mogućih problema:
– source i target imaju različit broj redova
– transformacija odbacuje određene zapise
– duplikati postoje u ciljnom sloju
– određeni poslovni period nije kompletan
– deo podataka kasni iz drugog izvora
– tehnički uspeh i kvalitet rezultata čuvaju se kao isti status
Posebno je problematično kada korisniku prikažemo samo zeleno:
SUCCESS ✅
Takva poruka stvara vrlo jasan mentalni zaključak: „sve je u redu“.
Mnogo korisniji status je:
Izvršavanje: SUCCESS
Validacija: FAILED
Extracted: 12.480
Loaded: 12.103
Razlika: 377
Korisnik ili tehnička podrška tada ne moraju da analiziraju deset logova da bi razumeli problem.
Informacija odmah pokazuje šta nije u redu.
Kako rešiti ovaj problem
Rešenje nije samo detaljniji log. Potrebno je ugraditi validaciju u sam pipeline.
To podrazumeva:
- Brojati izvučene redove
Nakon ekstrakcije sačuvati: extracted_count
Sistem mora da zna koliko je zapisa dobio iz izvora.
- Brojati učitane redove
Nakon upisa sačuvati: loaded_count
Tako možemo odmah da proverimo da li se broj promenio tokom transformacije i učitavanja.
- Proveriti konačno stanje
Nakon završetka obrade proveriti koliko očekivanih zapisa stvarno postoji u ciljnom sloju.
To daje: final_count
- Proveriti duplikate
Isti broj redova nije dovoljan ako je deo originalnih zapisa izgubljen, a drugi deo dupliran.
Potrebna je kontrola poslovnog ili tehničkog ključa.
- Uvesti poslovne validacije
Na primer:
– da li postoji očekivani poslovni datum
– da li su količine u dozvoljenom opsegu
– da li ključna polja imaju vrednost
– da li su učitani svi očekivani objekti
- Odvojiti statuse
Pipeline može imati:
Execution Status = SUCCESS
Validation Status = FAILED
To nije kontradikcija. Kod je uspešno završio, ali rezultat nije zadovoljio kontrolu.
- Upozoriti pre osvežavanja dashboarda
Ako validacija ne prođe, BI sistem treba da:
– označi obradu kao neispravnu
– pošalje upozorenje
– po potrebi spreči objavljivanje nepotpunih podataka
Najjednostavnije pravilo može da bude: extracted = loaded = final uz dodatnu proveru da nema neočekivanih duplikata.
Na ovaj način BI sistemi ne proveravaju samo da li je pipeline živ. Proveravaju da li je proizveo podatke koji mogu bezbedno da se koriste.
Kako to izgleda u praksi
Na jednom dnevnom pipeline-u za podatke o zalihama odvojili smo izvršavanje od validacije. Za svako pokretanje sistem čuva podatke poput:
Extracted rows: 12.480
Loaded rows: 12.103
Final rows: 12.103
Execution: SUCCESS
Validation: FAILED
Tehnički proces je završen. Ali obrada nije proglašena zdravom.
Sistem zatim može da evidentira razliku: Expected vs. loaded: –377
i pošalje upozorenje odgovornoj osobi.
Za ispravno izvršavanje stanje bi izgledalo:
Extracted: 12.480
Loaded: 12.480
Final: 12.480
Duplicates: 0
Validation: PASSED 🔍
Tek tada se rezultat smatra spremnim za korišćenje. Najvažnija promena nije novi dashboard. Promena je u tome što nedostajući podaci više ne mogu neprimetno da prođu kroz pipeline.
Najčešće greške
Najčešće greške kod BI pipeline-a su:
– oslanjanje samo na exit code procesa
– status SUCCESS bez podatkovne validacije
– provera samo broja učitanih redova
– ignorisanje duplikata
– nepostojanje očekivanog poslovnog perioda
– slanje alarma samo kada aplikacija potpuno padne
– ručna provera kvaliteta tek nakon prijave korisnika
Posebno je opasno koristiti jedan status za sve.
SUCCESS ne treba da znači:
„podaci su sigurno tačni“.
Treba da znači samo: „izvršavanje nije završilo tehničkom greškom“.
Kvalitet rezultata zahteva zasebnu proveru.
Zaključak
Pouzdani BI sistemi ne proveravaju samo da li je proces završen.
Oni proveravaju i šta je taj proces proizveo. To znači da sistem treba da:
– meri broj izvučenih podataka
– meri broj učitanih podataka
– proverava konačno stanje
– otkriva duplikate
– validira poslovni period
– odvaja execution i validation status
– automatski reaguje kada se rezultat ne poklapa sa očekivanim
Bez toga pipeline može biti potpuno zelen, dok dashboard prikazuje nepotpune podatke.
SUCCESS je status izvršavanja. Poverenje zahteva validaciju.
Ako BI pipeline trenutno proverava samo da li je tehnički završen, možemo analizirati postojeći tok obrade, kontrole broja zapisa, duplikate i validaciona pravila.
Cilj je da sistem sam otkrije nepotpun rezultat pre nego što takvi podaci stignu do dashboarda i poslovnih korisnika.
Prvi razgovor je tehnički i bez obaveza.